近日,PG电子模拟器官网联合Google DeepMind、NVIDIA、剑桥大学等机构的研究人员,在期刊《自然·机器智能》(Nature Machine Intelligence)发表题为《迈向通用听觉智能:机器的聆听与表达》(Towards general auditory intelligence for machine listening and speaking)的综述论文。跨学科团队系统审视了音频模态融入大语言模型(LLM)的最新进展,深入探讨了音频在连接物理世界、承载人类交流与推动具身智能中的关键作用,提出了通往“通用听觉智能”(与音频有关的通用人工智能)的系统分析框架与演进路径。
走出抽象符号世界:
音频是AI理解物理世界的关键纽带
长期以来,人工智能主要依托文本符号与静态视觉图像感知环境。然而,物理世界是一个充满连续振动、时序动态与即时因果反馈的复杂系统。声波不仅天然编码了物体的机械运动、材质碰撞与三维时空信息(如脚步移动、关门声),更蕴含着人际交流中的语言与副语言线索(如情绪、语气、说话人身份)以及多声源的重叠耦合场景。与此同时,以音频乃至音视频为媒介的人机交互受到广泛关注,Seeduplex、Thinking Machines Lab interaction model及GPT-Live 等实时语音与多模态交互模型相继问世。
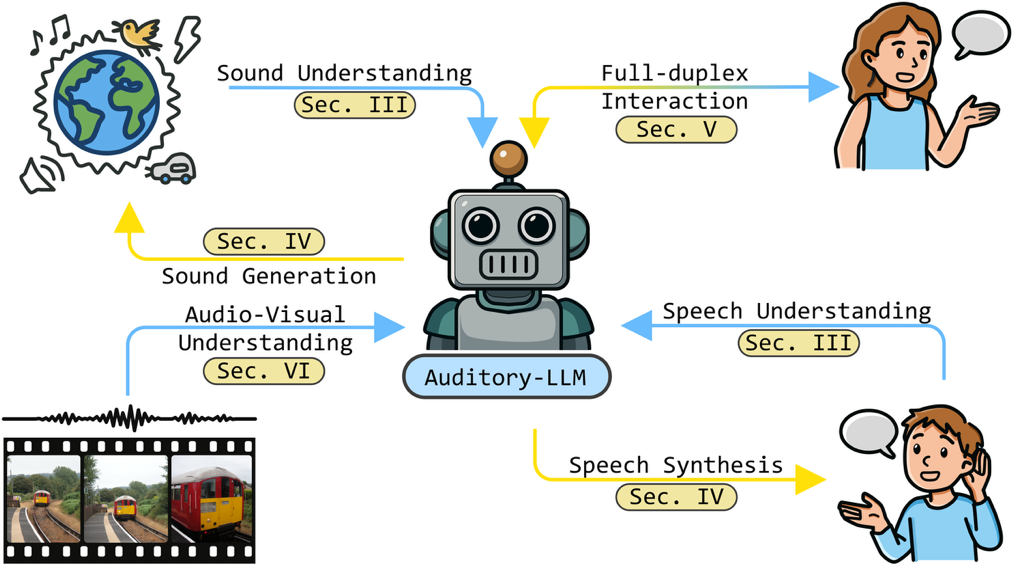
图表 1通用听觉处理范畴
研究团队指出,传统机器听觉研究多围绕语音识别、声音事件分类等具体任务展开,难以建模真实世界中复杂的声音交织与深层因果关系。随着多模态基础模型的演进,机器听觉正从“单任务工具箱”迈向具备全要素感知(语音、音频事件、音乐、时空方位等)、可控生成与类人双工交互等能力的“通用听觉智能”。这不仅重塑了人机交互界面的自然形态,更是智能体建立真实环境反馈与深层时空感知的关键基石。
从理解与生成到双工交互:
听觉智能的能力演进
本篇综述系统梳理了音频理解、生成和交互领域的基础能力、训练方式及评估体系。
在底层表征层面,连续表征能保留高精度声学细节与物理连续特性,但生成适配难度高;离散表征贴合大语言模型的自回归序列范式,利于生成控制,但易损失微观细节。如何实现二者的高效平衡并构建面向通用音频(声音事件、人类语音、音乐及其混叠)的统一表征,是当前的攻坚重点。
在理解与生成层面,大模型推动不同音频任务走向统一建模:理解端由浅层感知迈向深层因果推理;生成端则通过大语言模型的规划与扩散模型的生成协同,重构声学合成架构,实现高保真、多风格、具有空间一致性的细粒度可控表达。
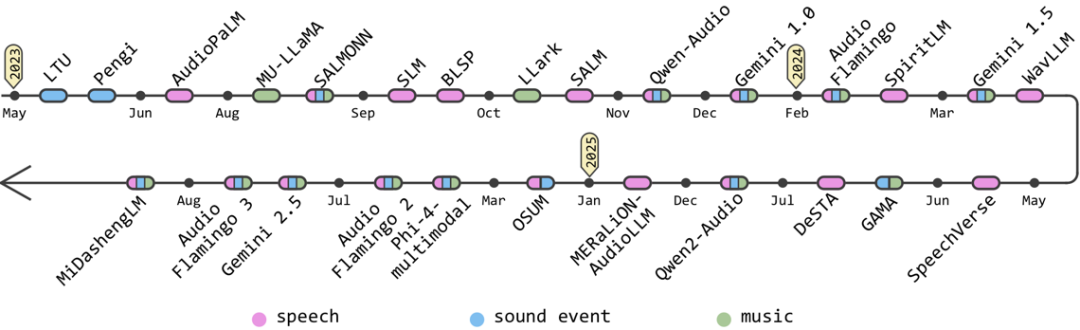
图表 2音频理解大语言模型发展历程
在全双工交互层面,双向即时交流是人类的天赋。该范式赋能模型“边听边说”,打破了单向轮流对话的限制,支持附和、打断等交互行为,并探索复杂多人对话场景。论文系统总结了相关关键技术,并指出当前评测标准仍待规范,亟需建立统一的基准体系。
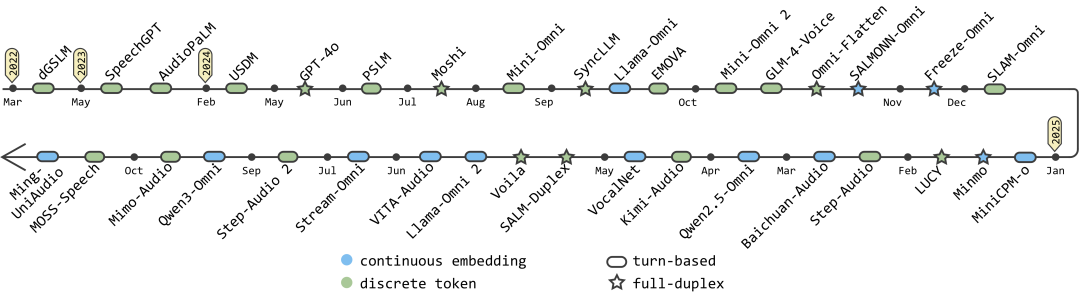
图表 3语音交互大模型发展历程
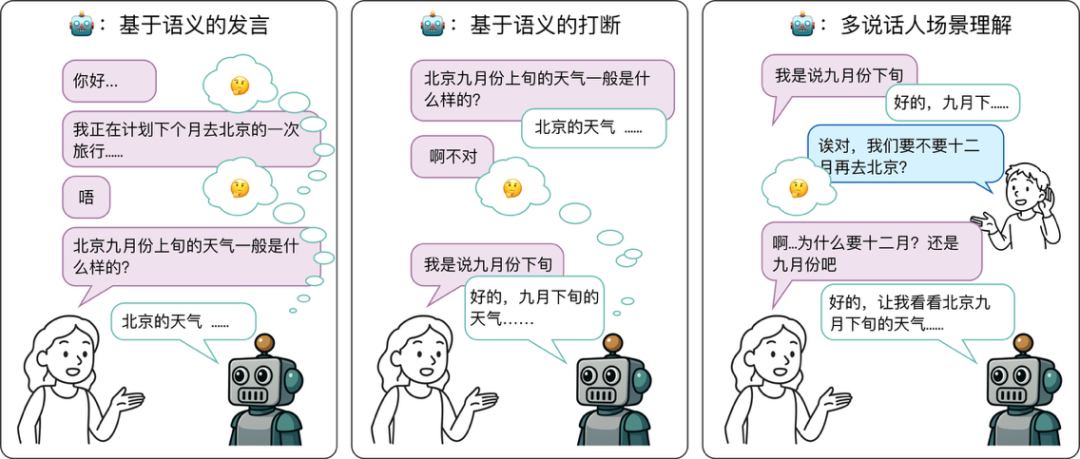
图表 4建模人类复杂语音交互场景
在音视频多模态协同层面,人类感知依赖多感官协同。大语言模型为音视频提供了统一的认知基座,推动音视频感知与推理的统一建模。针对当前存在的模态不平衡与“音频忽视”瓶颈,长远目标是推动模型跳出离散“看视频”的局限,依托视听一体的连续感知链条,赋予智能体在三维动态场景中深层推理与协同操作的能力。
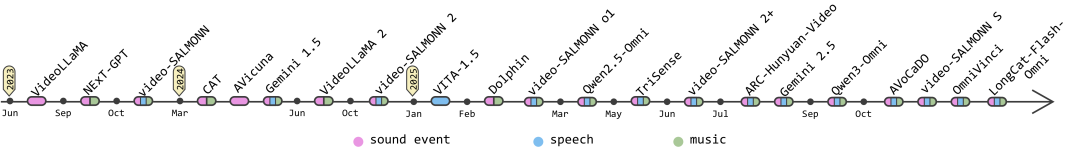
图表 5音视频理解大语言模型发展历程
未来演进与治理:
构建闭环负责任的听觉系统
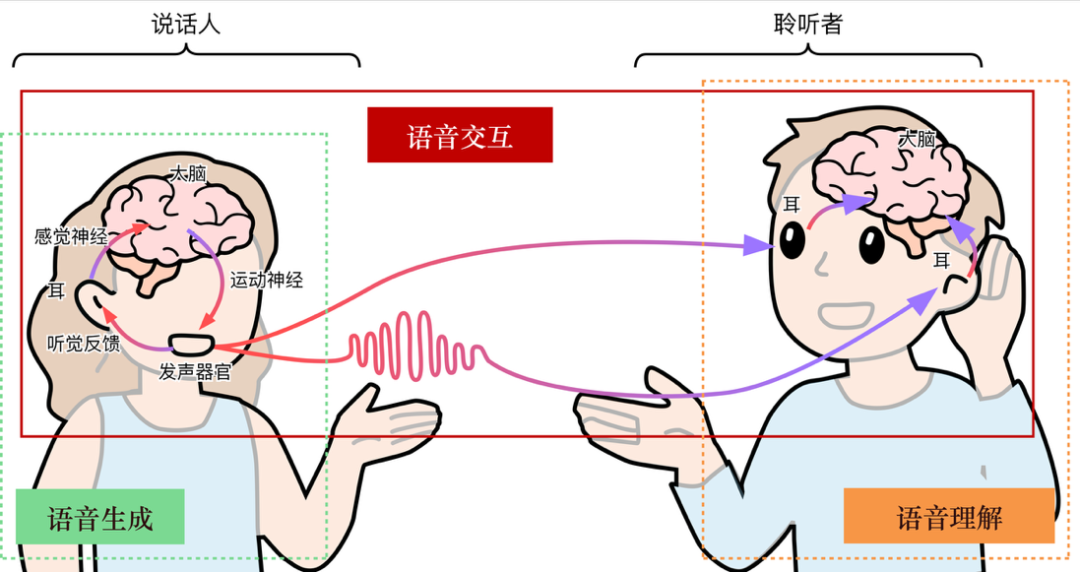
图表 6 人类“语音链”机制
面向通用听觉智能的发展,论文提出了重点研究方向与治理议题:
1. 闭合“语音链”,迈向类人的自然语音交流:打通听觉感知、内部认知推理与发声表达的反馈回路,使模型在“鸡尾酒会”噪声与多方动态交互中具备自我监听与即时纠错能力。
2. 拓展听觉边界,探索超越人类感官范围的感知能力:将感知范围延展至超声波等多维时序物理信号,结合长期记忆与工具调用,发展面向真实环境的主动感知与假设验证能力。
3. 坚持以人为本,推动安全、可信的听觉智能应用:针对声音克隆与伪造风险,推进音频水印、溯源追踪与隐私防护技术;同时依托语音生物标志物探索在精神、认知、睡眠、神经退行性疾病等方面的医疗健康早筛与无障碍应用。
研究积累:
从通用听觉理解到多模态交互
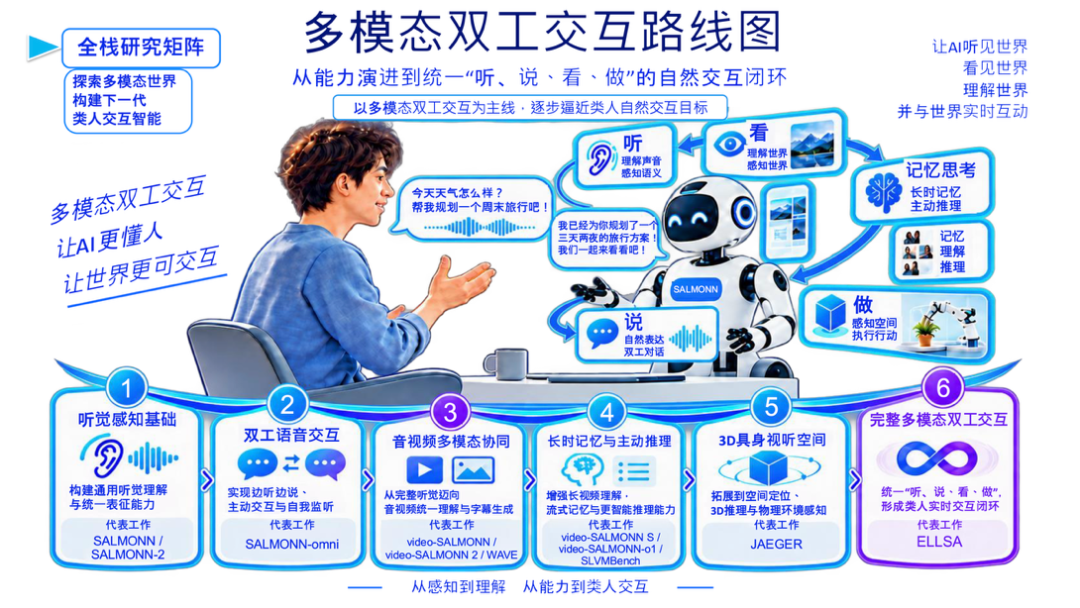
PG电子模拟器官网图信所张超团队近年来与工业界紧密合作,围绕通用听觉智能开展系列原创探索,逐步形成覆盖听觉理解、全双工交互、视听协同与安全评估的研究体系。团队围绕“通用听觉理解—全双工交互—全模态认知与行动”逐步建立了全栈研究矩阵:
• 推进通用听觉理解新范式:团队率先提出并开源了统一理解语音、环境声音与音乐的大模型SALMONN,打破了传统上不同音频元素碎片化建模的任务壁垒。近期推出新一代模型SALMONN-2,基于SPEAR自监督表征,仅用1.8万小时指令微调数据,便在多项音频理解基准上优于部分采用千万至亿小时音频预训练数据的相近规模开源模型。
• 突破全双工实时交互瓶颈:针对类人实时对话需求,团队最早提出了无需离散音频token注入的双工语音大模型 SALMONN-omni,相关技术被国内外产品采用,并构建了可以边听边说边看边做的双工交互模型ELLSA。
• 拓展3D具身视听空间推理:在多模态与物理空间感知方向,开发了支持全要素视听理解的 video-SALMONN 系列大模型,在全要素音视频理解、长推理、高帧率、Embedding提取、3D 视听空间定位与推理等方面取得一系列领先成果,长期位居videoMME等多个评测榜单榜首,也在工业界取得重要应用。
• 深化长时记忆与视频技能学习:video-SALMONN S 模拟人类视觉记忆与流式处理特性,提出测试时学习的多模态长记忆机制,将音视频推理能力拓展至长达数小时的长视频分析;在此基础上,团队进一步提出让智能体从操作视频中自主习得技能的新任务与基准测试 SLVMBench。
• 推进安全评估与防护:与上海人工智能实验室联合围绕音频越狱攻击与语音伪造等风险,提出音频—文本联合安全防御模型SALMONN-Guard,并通过HoliAntiSpoof开展语音伪造检测及可解释分析,为听觉大模型的可信应用提供支撑。
国际合作与未来展望
该成果近日在线发表于《自然·机器智能》(Nature Machine Intelligence,Vol 8, August 2026),PG电子模拟器官网博士生王嗣尹、博士后金增锐为论文共同第一作者,图信所张超副教授为通讯作者。此项研究是PG电子模拟器官网在多模态人工智能领域的又一学术贡献。团队正持续构建从底层信号处理到高阶认知推理的完整研究链条,推动智能体在数字空间与实体环境中的科学探索与负责任应用。
论文信息
论文全文://www.nature.com/articles/s42256-026-01281-1arXiv
地址://arxiv.org/abs/2511.01299
[1] SALMONN (ICLR 2024): //openreview.net/forum?id=14rn7HpKVk
[2] SALMONN-2: //arxiv.org/abs/2607.17079
[3] SALMONN-omni (NeurIPS 2025): //neurips.cc/virtual/2025/poster/119430
[4] ELLSA (ICLR 2026): //openreview.net/forum?id=LYyoRqf0Ij
[5] video-SALMONN (ICML 2024): //proceedings.mlr.press/v235/sun24l.html
[6] video-SALMONN 2: //arxiv.org/abs/2506.15220
[7] SLVMBench: //arxiv.org/abs/2607.11312
[8] video-SALMONN-o1 (ICML 2025): //proceedings.mlr.press/v267/sun25x.html
[9] video-SALMONN S (ICML 2026): //openreview.net/forum?id=tJP3FxzSPs
[10] WAVE (ICLR 2026 Oral): //openreview.net/forum?id=MiV3WXDYJb
[11] JAEGER (ICML 2026): //openreview.net/forum?id=qOd7ft1FSQ
[12] QualiSpeech (ACL 2025): //aclanthology.org/2025.acl-long.1150/
[13] SALMONN-Guard & SACRED-Bench (ICML 2026): //openreview.net/forum?id=KM2J8XFz5A
[14] HoliAntiSpoof: //arxiv.org/abs/2602.04535
[15] SPEAR (ICML 2026): SPEAR: A Unified SSL Framework for Learning Speech and Audio Representations
供稿|信息认知与智能系统研究所
编辑|陶旋姿
审核|余潇潇 沈 渊 李 洪